AI時代的抉擇 以“信”筑基,行穩“智”遠——互聯網數據服務的破局之道
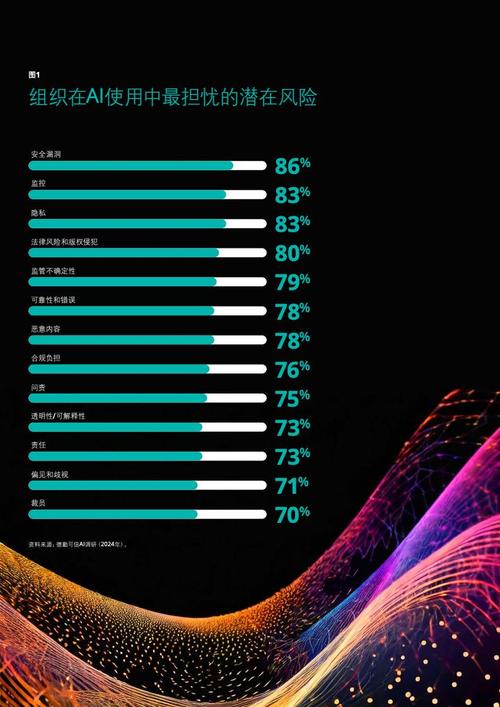
當生成式AI以前所未有的速度迭代,當大模型參數量從億級躍升至萬億級,當“智能體”開始接管搜索、推薦、客服甚至決策——互聯網數據服務行業正站在一個關鍵的十字路口。一面是AI帶來的效率革命與想象空間,另一面是數據濫用、隱私泄露、算法偏見與“幻覺”頻發的信任危機。在這場技術與倫理的賽跑中,行業必須做出抉擇:是狂飆突進、先跑再說,還是以“信”筑基、行穩“智”遠?
一、AI的“智”,離不開數據的“質”與“信”
互聯網數據服務的核心價值,從來不只是“數據搬運”或“管道流量”。在AI時代,數據是燃料,但燃料若摻了雜質,引擎反而會爆震。訓練一個智能客服,若語料中充滿誤導性問答、廣告噪音或歧視性表達,結果只能是“智能降級,智障升級”。
以信筑基,意味著數據服務商必須建立全生命周期的質量與信任體系:
來源可信:數據采集須合規授權,杜絕黑灰產爬蟲、竊取隱私。
處理可信:清洗、標注、脫敏環節需要可審計、可追溯。
* 使用可信:向AI企業輸出數據時,不能犧牲用戶權益,更不能制造信息繭房或操縱輿論。
沒有“信”,AI越智能,用戶越恐懼。此前某大模型因引用未經證實的醫療數據給出錯誤建議,就是活生生的教訓。互聯網數據服務者的第一責任,是為AI裝好“信任剎車”。
二、行業現狀:三種“異化”威脅信任根基
當前互聯網數據服務中,三種傾向正在動搖“信”的基石:
1. 貪快求全的“數據注水”:為沖刺大模型訓練效率,部分服務商大量錄入未經核驗的網絡文本、洗稿內容、機器問答,造成模型輸出“看似有理、實則胡說”。
2. 隱秘的隱私交換:免費API、代理池、掃碼連WiFi……數據在沒有清晰告知的前提下被匯聚、轉賣、亂用,消費者成為“智能燃料”卻不自知。
3. 數據孤島與算法割據:大平臺守著自己數據不準接入,小服務商靠灰色手段拼湊。表面是AI缺失數據,實則是信任機制崩塌。
這些急功近利的做法看似加速了AI落地,實則讓全行業陷入“用一次錯一次,信一次傷一次”的循環。信任構建極難,崩塌卻在一瞬。行穩“智”遠,首先要忍住那些消耗信任的近路。
三丶行穩“智”遠的實踐路徑:透明、確權、去噪、共生
如何從口號走向地面?互聯網數據服務可遵循四步:
透明化分級分類:對數據集來源、適用場景、敏感等級清晰披露。像食品標注成分一樣標注數據“成分”,供AI開發者事前評估。
加固數據確權與脫敏技術:運用聯邦學習、差分隱私、可信執行環境等技術,做到“數據可用不可見,知識可用不可泄”。
主動去噪與人類反饋清洗:引入首席信任官或數據倫理委員會,以大篩查、人機結合質檢等方式清洗有毒和偏見數據。
構建共生生態:運營商、云服務、行業聯盟共同扶正拒灰;建立可信數據空間與標注標準,讓小機構和獨立開發者也享有高質量合規數據。
目前已有先行者。中國多家數據交易所推行的“三權分立”數據的登記、評估、交易試點,以及信通院主導的數據信托沙盒,都在朝向能驗證、追責明確的方向探索。一旦建成可量化的“確定性信任經濟”,AI才能成為規模應用的靠譜引擎。
四、AI應是可信的放大鏡,而非湮沒信任的魔境
今天在選擇技術路線時,每一家互聯網數據服務商都在回答一個終極問題——我們只是在滿足參數驅動的“嗜血需求”,還是在鑄造可以托付的智能基礎設施?
孟子云:“敬人者,人恒敬之;愛人者,人恒愛之。”對待用戶的每個字節,唯有以敬畏心采集、用責任心治理,做到可查、可控、可告、可訴,才有可能不再困于短期主義,而在人工智能的大航海時代建設真正的智信駕駛艙。以信筑基,行穩以致千里。
如若轉載,請注明出處:http://www.scwxkj.com/product/42.html
更新時間:2026-10-02 19:43:51